
Nếu Google không thể tìm thấy và đọc nội dung của bạn để lập chỉ mục (index) thì mọi nỗ lực viết bài đều trở nên vô nghĩa. Đây là lúc chúng ta cần bàn về Crawl Budget. Bài viết này dành cho website TMĐT, báo chí, site lớn (10.000+ URL) hoặc website gặp tình trạng index chậm dù đã tối ưu nội dung.
Vậy Crawl Budget là gì? Nó ảnh hưởng thế nào đến khả năng Google index? Khi nào website của bạn thực sự cần quan tâm đến vấn đề này? Hãy cùng AZSOL tìm câu trả lời và giải pháp tối ưu qua bài viết dưới đây.
Tổng quan về Crawl Budget
Crawl Budget là gì?

Để hiểu Crawl Budget là gì, bạn hãy hình dung Googlebot như một vị khách đi vào thư viện (website của bạn). Vì thời gian và sức lực có hạn, họ không thể đọc hết hàng triệu cuốn sách trong một ngày.
Crawl Budget (ngân sách thu thập dữ liệu) chính là số lượng tối đa các trang (URL) mà Googlebot có thể và muốn thu thập trên website của bạn trong một khoảng thời gian nhất định.
Khái niệm Crawl Budget thường được nhắc đến nhiều khi website mở rộng quy mô lớn. Trên thực tế, các nền tảng SEO quốc tế như :When Should You Worry About Crawl Budget? cũng chỉ ra rằng Crawl Budget chỉ thực sự trở thành vấn đề khi website có số lượng lớn URL hoặc cấu trúc phức tạp, khiến Googlebot không thể thu thập dữ liệu hiệu quả.
Cần lưu ý rằng Crawl Budget không đồng nghĩa với khả năng lập chỉ mục (Index). Việc Googlebot thu thập được một URL không đảm bảo URL đó sẽ được đưa vào chỉ mục. Tương tự, tần suất Googlebot quay lại thu thập (crawl frequency) cũng không phản ánh mức độ ưu tiên xếp hạng (crawl priority). Một website có thể được crawl thường xuyên, nhưng nếu nội dung kém chất lượng hoặc trùng lặp, Google vẫn có thể không index hoặc không xếp hạng trang đó.
Hai yếu tố hình thành Crawl Budget

Trong quá trình thu thập dữ liệu (Crawling), ngân sách này sẽ được tính toán dựa trên hai yếu tố chính:
- Giới hạn tốc độ thu thập (Crawl Rate Limit): Google sẽ xem xét “sức khỏe” của máy chủ (server). Nếu server phản hồi nhanh, bot sẽ thu thập nhiều hơn. Ngược lại, nếu việc thu thập làm web bị chậm hoặc lỗi, bot sẽ tự động giảm số lượng trang ghé thăm để tránh làm sập web.
- Nhu cầu thu thập (Crawl Demand): Mức độ phổ biến và tính mới mẻ của nội dung. Các trang có nhiều traffic hoặc được cập nhật thường xuyên sẽ được Google ưu tiên ghé thăm nhiều hơn.
Cần lưu ý rằng Crawl Budget không đồng nghĩa với khả năng lập chỉ mục (Index). Việc Googlebot thu thập được một URL không đảm bảo URL đó sẽ được đưa vào chỉ mục.
Tương tự, tần suất Googlebot quay lại thu thập (crawl frequency) cũng không phản ánh mức độ ưu tiên xếp hạng (crawl priority). Một website có thể được crawl thường xuyên, nhưng nếu nội dung kém chất lượng hoặc trùng lặp, Google vẫn có thể không index hoặc không xếp hạng trang đó.
Khi nào website cần quan tâm tới Crawl Budget?
Đa số các website trên internet không cần quá lo lắng về Crawl Budget. Để xác định xem bạn có nên đầu tư nguồn lực cho vấn đề này hay không, hãy tham khảo bảng so sánh dưới đây để có cái nhìn chính xác nhất.
| Tiêu chí | Website KHÔNG cần lo lắng | Website CẦN tối ưu ngay |
| Quy mô | Dưới 1.000 URL (Blog cá nhân, Web doanh nghiệp nhỏ). | Trên 10.000 URL (TMĐT, Báo chí, Web tổng hợp). |
| Nội dung | Ít thay đổi, cập nhật định kỳ. | Cập nhật liên tục theo giờ/ngày (Tin tức, Giá cả). |
| Cấu trúc URL | Đơn giản, tĩnh. | Phức tạp, sinh ra nhiều URL tham số (Bộ lọc, Search). |
| Hành động | Tập trung vào chất lượng nội dung (Content). | Tập trung vào kỹ thuật (Technical SEO) & Crawl Budget. |
Bảng so sánh mức độ ưu tiên tối ưu
Thực tế triển khai:
Trong quá trình audit một website thương mại điện tử quy mô lớn (~120.000 URL), AZSOL ghi nhận hơn 45% crawl budget bị tiêu tốn vào các URL không mang giá trị SEO, chủ yếu đến từ:
-
URL bộ lọc sản phẩm (
?color=,?price=…) -
Trang tìm kiếm nội bộ (internal search)
-
URL tham số tracking & sắp xếp (
?sort=,?utm_source=)
Checklist kiểm tra Crawl Budget cho website lớn:
Nếu website của bạn có từ 10.000 URL trở lên và gặp tình trạng index chậm, hãy kiểm tra nhanh các yếu tố sau trước khi tối ưu sâu hơn:
-
Kiểm tra Crawl stats trong Google Search Console để xem Googlebot đang crawl bao nhiêu URL mỗi ngày
-
Xác định các URL không mang giá trị SEO (filter, search nội bộ, tham số tracking)
-
Kiểm tra tỷ lệ URL được crawl nhưng không được index
-
Rà soát sitemap XML: chỉ chứa URL chuẩn (200, indexable)
-
Kiểm tra website có phát sinh URL trùng lặp hoặc tham số động không
-
Đảm bảo các trang quan trọng nằm ≤ 3 click từ trang chủ
Hệ quả là nội dung sản phẩm mới và landing page quan trọng bị Googlebot thu thập chậm, dù website có authority tốt và nội dung được cập nhật thường xuyên.
Sau khi xử lý canonical, noindex các URL không cần thiết và tinh chỉnh sitemap, tốc độ index các trang quan trọng cải thiện rõ rệt chỉ sau 2–3 tuần, đồng thời giảm tải crawl không cần thiết cho server. Cách dựng một file sitemap.xml chuẩn, kể cả sitemap ảnh và video, được Tài Nguyên SEO trình bày chi tiết.
Quản lý Crawl budget tác động trực tiếp đến SEO như thế nào?
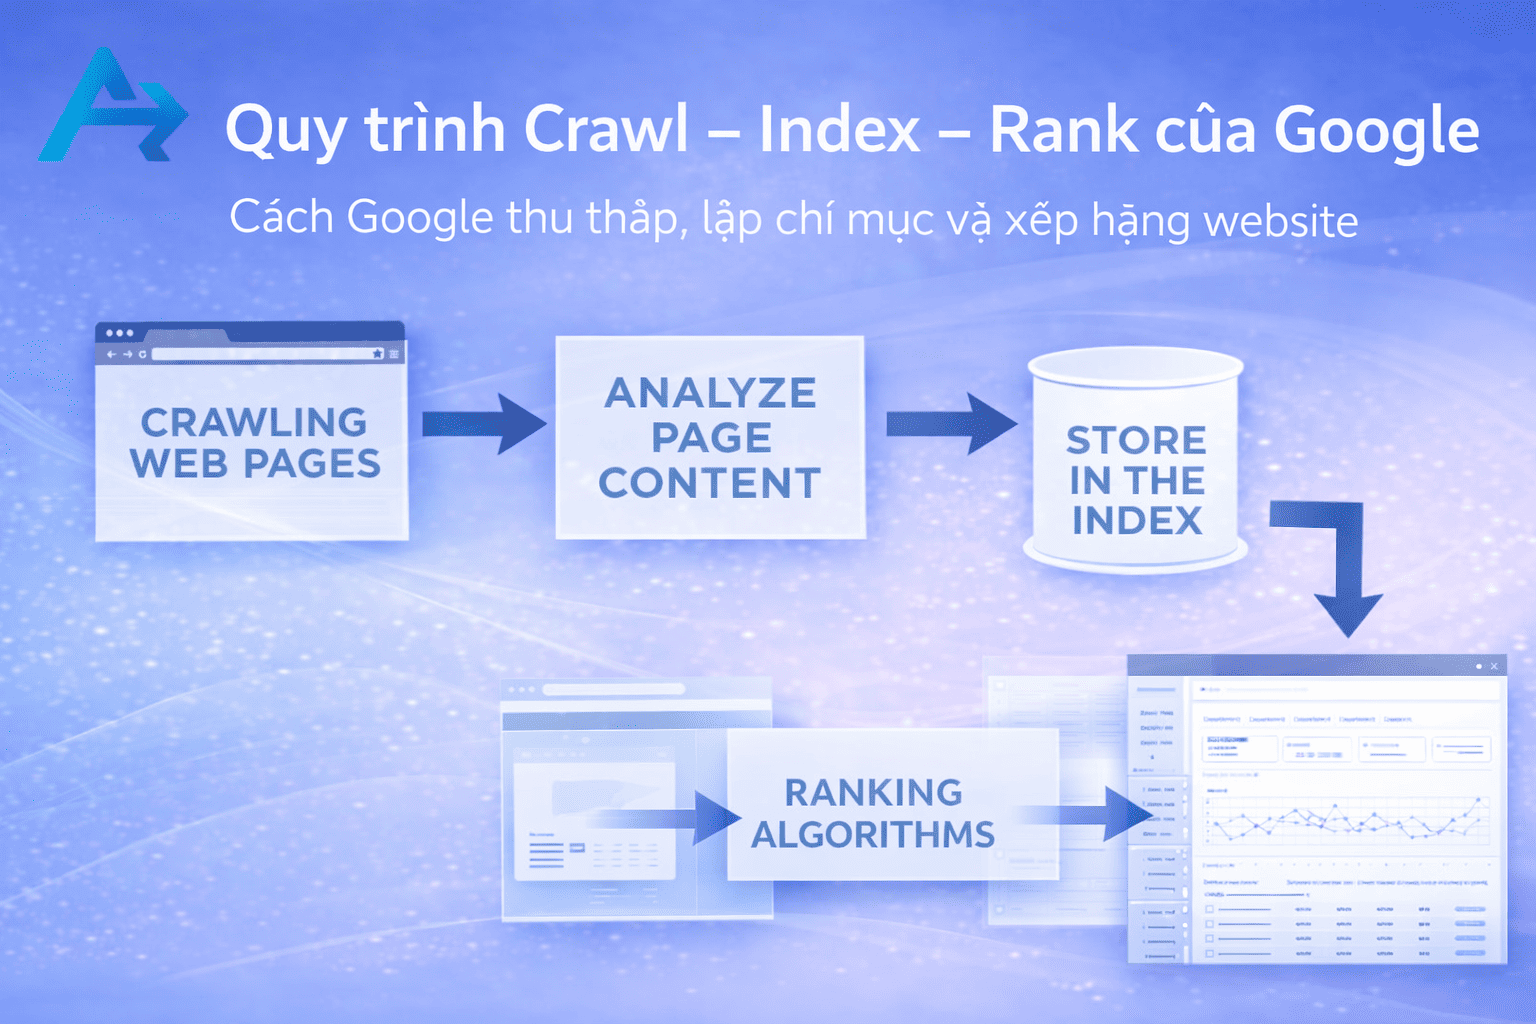
Nếu website của bạn thuộc nhóm cần tối ưu nhưng lại bỏ qua Crawl Budget, nó sẽ tác động trực tiếp đến doanh thu và traffic. Quy trình SEO hoạt động luôn tuân theo các bước: Crawl (thu thập) -> Google Index (lập chỉ mục) -> Rank (xếp hạng). Nếu bước đầu không thuận lợi cho Googlebot, hai bước sau sẽ không xảy ra.

Dưới đây là 3 tác động chính:
Nội dung mới chậm được Index (lập chỉ mục)
Crawl Budget bị tiêu tốn hết vào các trang cũ và trang lỗi khiến Googlebot rời đi trước khi nhìn thấy bài mới của bạn. Điều này ảnh hưởng trực tiếp đến hiệu suất hiển thị dù nội dung có hay đến mấy.
Nội dung cập nhật không được ghi nhận
Khi bạn sửa giá hoặc cập nhật bài viết, Googlebot sẽ “lười” quay lại nếu ngân sách thấp. Khách hàng thấy thông tin lỗi thời sẽ không nhấp vào xem, làm giảm tỷ lệ CTR và trải nghiệm người dùng.
Lãng phí tài nguyên server
Googlebot đi thu thập trang rác sẽ làm tốn băng thông, khiến website bị chậm đối với người dùng thật.
Thứ tự tối ưu Crawl Budget hiệu quả
Không phải mọi website đều cần tối ưu Crawl Budget ngay lập tức. Để tránh lãng phí nguồn lực, bạn nên ưu tiên theo thứ tự sau:
Ưu tiên 1 – Dọn rác URL (BẮT BUỘC)
-
Noindex trang search nội bộ, filter không SEO
-
Canonical các URL trùng lặp
-
Chặn bot crawl khu vực không cần thiết
Ưu tiên 2 – Điều hướng Googlebot
-
Tối ưu internal link cho trang quan trọng
-
Đưa money page vào sitemap
-
Giảm độ sâu click
Ưu tiên 3 – Tối ưu hiệu suất crawl
-
Cải thiện tốc độ server
-
Giảm redirect chain & lỗi 404
-
Theo dõi crawl stats định kỳ
=> Chỉ khi hoàn thành ưu tiên 1 & 2, việc tối ưu tốc độ crawl mới thực sự mang lại hiệu quả rõ rệt.
Chiến lược tối ưu ngân sách thu thập dữ liệu
Mục tiêu của chúng ta là giúp quá trình Google Crawl diễn ra trơn tru nhất, chỉ dẫn bot đến những trang có giá trị nhất. Hãy bắt tay vào ngay với các bước dưới đây.
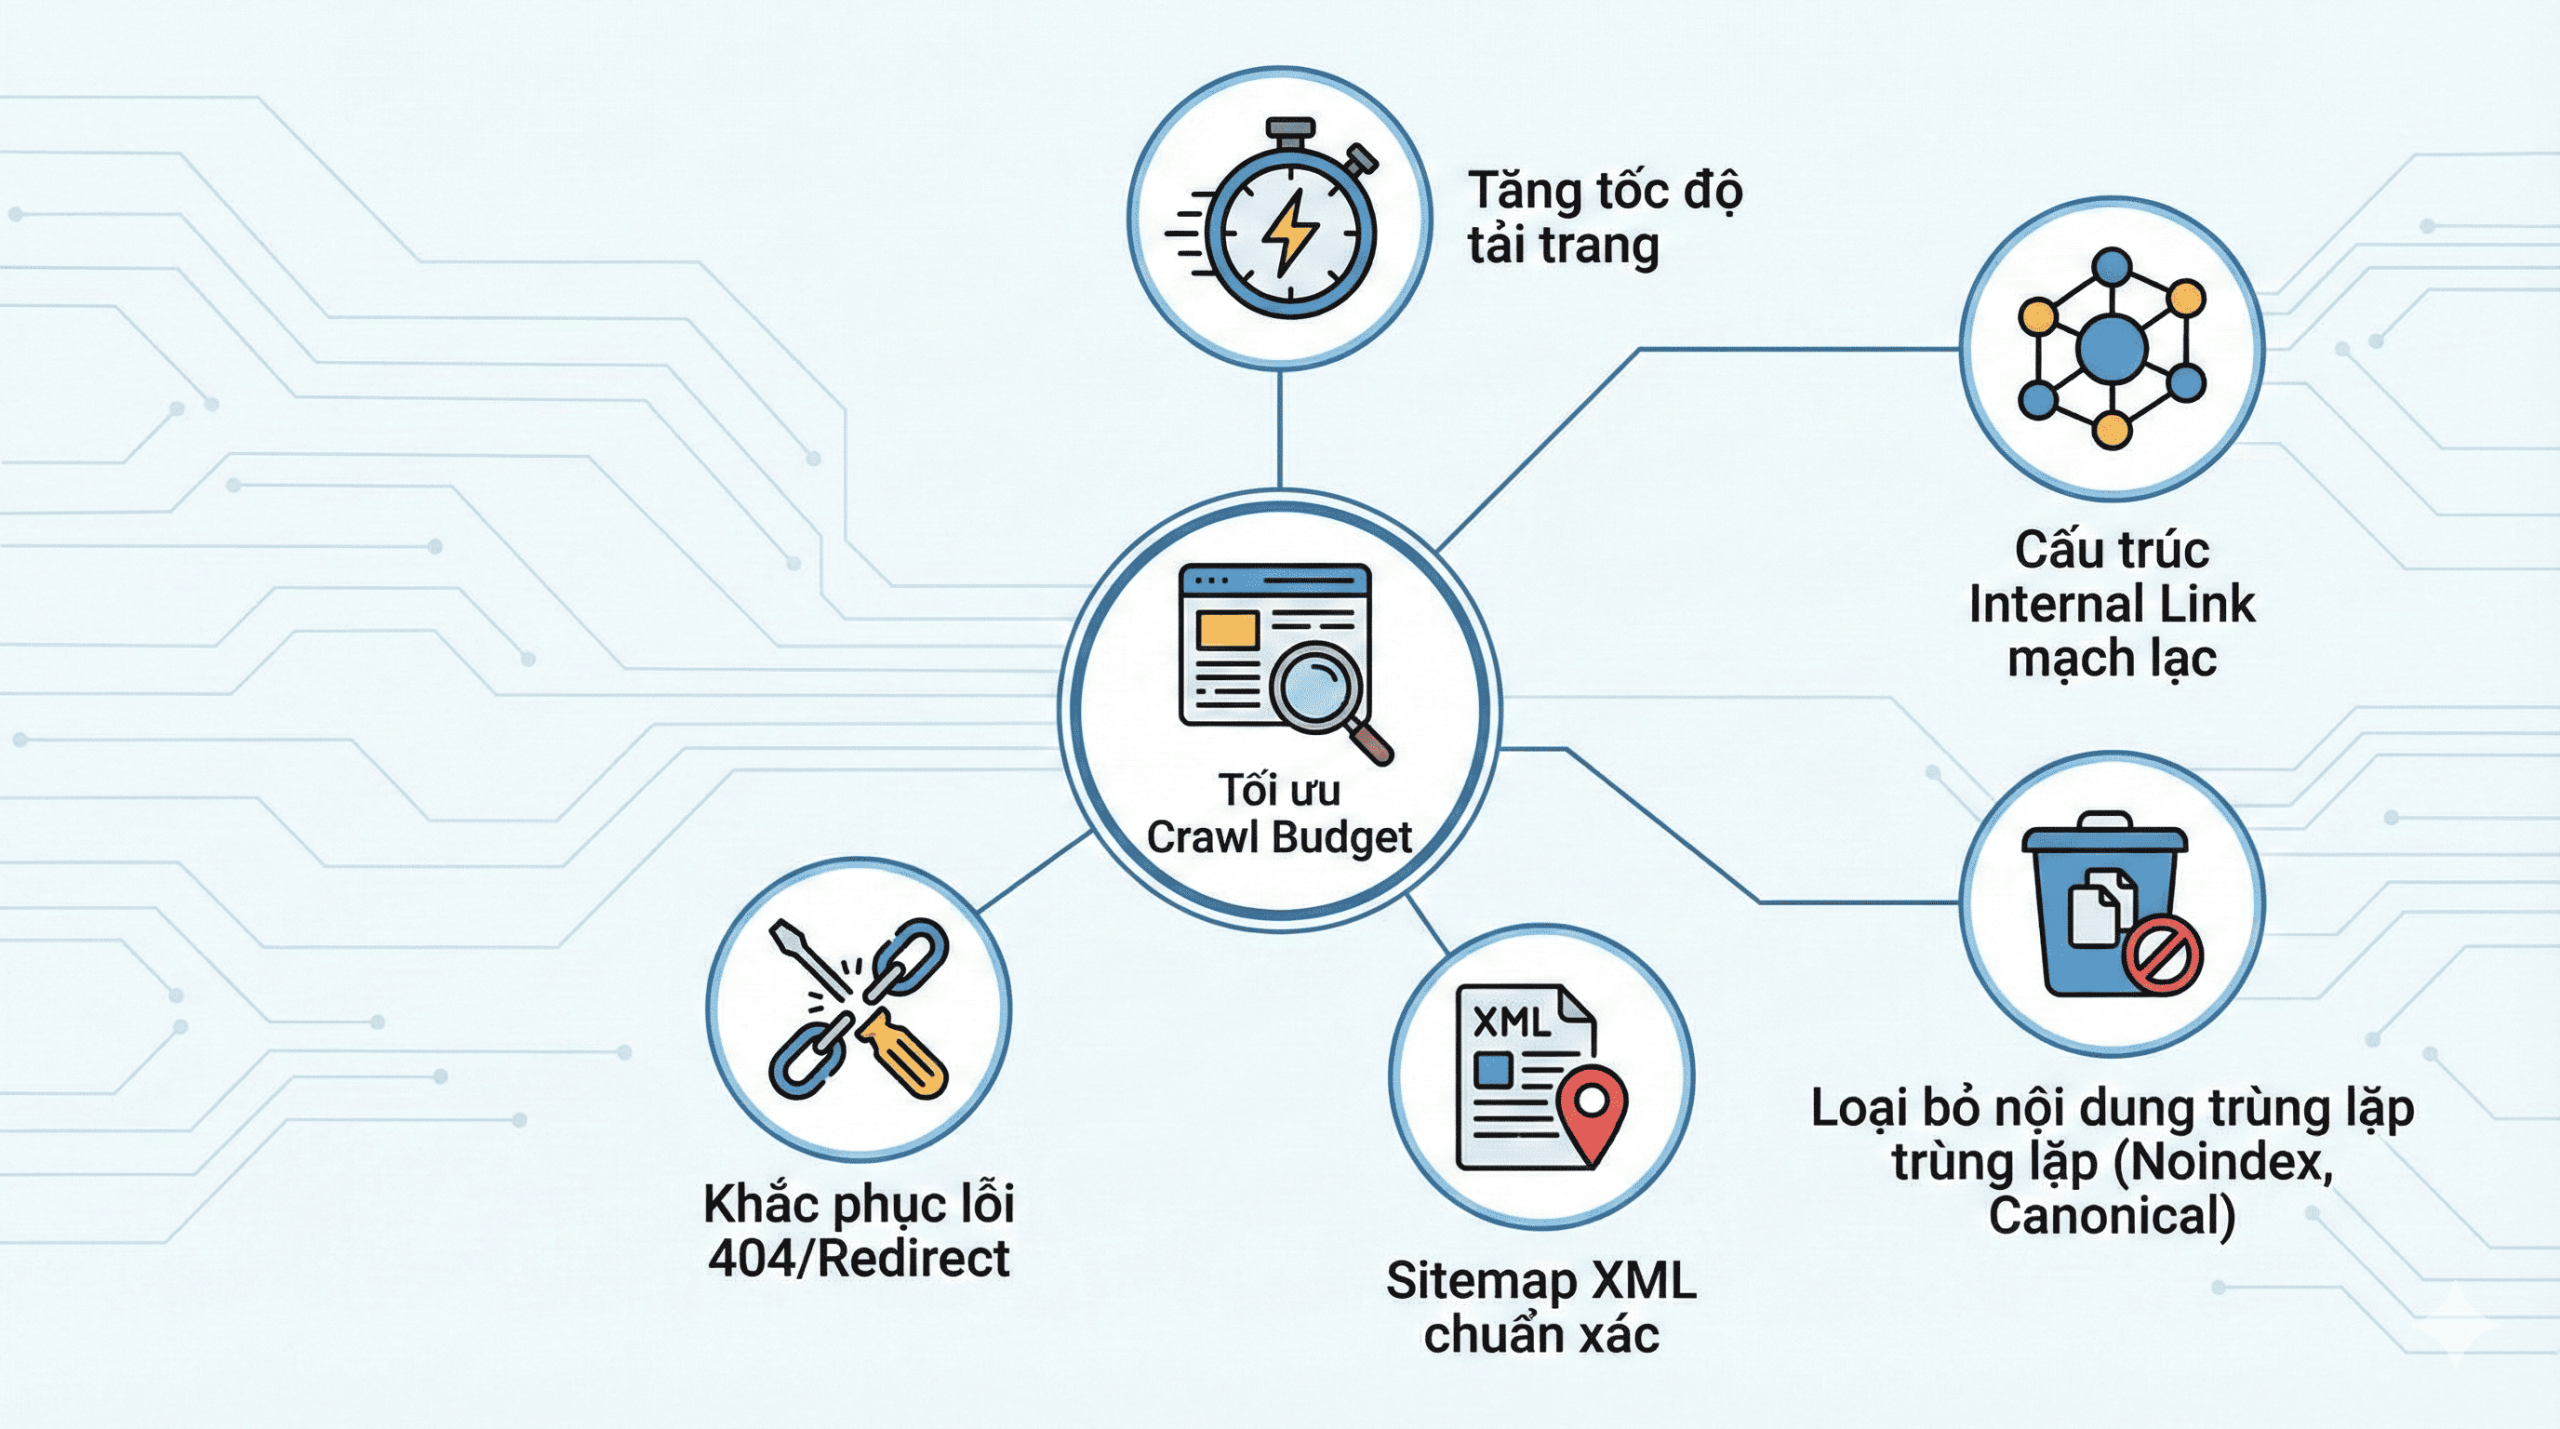
Tăng tốc độ tải trang
Tốc độ tải trang chậm sẽ làm tốn thời gian của Googlebot. Hãy tối ưu hình ảnh, sử dụng bộ nhớ đệm (cache) và nâng cấp server nếu cần thiết. Web chạy nhanh giúp bot thu thập được nhiều URL hơn trong cùng một khoảng thời gian.
Xây dựng cấu trúc liên kết nội bộ (Internal link) mạch lạc
Googlebot di chuyển dựa trên các đường link. Các trang quan trọng cần được liên kết rõ ràng và nằm nông trong cấu trúc website (tốt nhất là cách trang chủ không quá 3 lần nhấp chuột). Tránh tạo ra các trang mồ côi (orphan pages) – những trang không có ai trỏ tới.
Hạn chế hoặc loại bỏ nội dung trùng lặp
Các URL trùng lặp (duplicate content) thường phát sinh do tham số URL (ví dụ: ?sort=asc, ?utm_source=facebook). Giải pháp xử lý:
- Dùng Canonical tag để hợp nhất tín hiệu về một phiên bản chuẩn.
- Áp dụng thẻ Noindex với những trang không mang lại giá trị tìm kiếm (trang admin, giỏ hàng).
- Sử dụng robots.txt để chặn bot vào các khu vực không cần thiết.
Sử dụng Sitemap XML chuẩn xác
Sitemap là bản đồ chỉ đường cho bot. Hãy đảm bảo sitemap của bạn chứa các URL chuẩn (status 200), không chứa trang lỗi 404, trang đã chuyển hướng hoặc bị chặn index.
Khắc phục các liên kết gãy
Mỗi lần Googlebot đi vào một trang lỗi 404 hoặc bị chuyển hướng lòng vòng (A sang B, B sang C), nó đang lãng phí một phần ngân sách. Hãy thường xuyên kiểm tra Google Search Console để phát hiện và xử lý các lỗi này

Câu hỏi thường gặp (FAQ)
Dưới đây là giải đáp nhanh cho những thắc mắc phổ biến về Crawl Budget:
Làm sao biết Googlebot ghé thăm website của tôi bao nhiêu lần?
Bạn có thể xem chi tiết trong Google Search Console, tại mục “Cài đặt” (Settings) > “Báo cáo thống kê thu thập dữ liệu” (Crawl stats).
Có cách nào yêu cầu Google thu thập lại dữ liệu ngay lập tức không?
Có, nhưng thủ công. Bạn có thể dùng công cụ “Kiểm tra URL” (URL Inspection) trong Google Search Console và bấm “Yêu cầu lập chỉ mục” (Request Indexing). Tuy nhiên, cách này chỉ dùng cho từng URL lẻ, không áp dụng được cho toàn bộ website cùng lúc.
Bao lâu thì Googlebot quay lại thu thập website một lần?
Không có thời gian cố định. Các trang quan trọng (Trang chủ, bài viết Hot) có thể được thu thập hàng ngày, thậm chí hàng giờ. Các trang ít quan trọng hoặc nằm sâu trong cấu trúc web có thể mất vài tuần hoặc vài tháng Googlebot mới quay lại một lần.
Website nhỏ có cần quan tâm đến Crawl Budget không?
Thường là không. Với website dưới vài nghìn URL, Googlebot dư sức thu thập hết dữ liệu trong ngày. Bạn nên ưu tiên thời gian để tạo nội dung chất lượng.
Chặn Googlebot bằng robots.txt có giúp tăng thứ hạng không?
Gián tiếp là có. Việc chặn bot vào các trang rác giúp tiết kiệm ngân sách để bot tập trung vào các trang quan trọng (Money pages), từ đó giúp các trang này được index nhanh hơn.
Kết luận
Crawl Budget không phải là yếu tố xếp hạng trực tiếp, nhưng nó là điều kiện cần để website của bạn có thể xuất hiện trên Google. Đối với các website lớn, việc quản lý tốt ngân sách này giống như việc phân luồng giao thông: giúp dòng chảy dữ liệu thông suốt, đảm bảo những nội dung giá trị nhất luôn được Google nhìn thấy.
Nếu bạn chưa biết nên làm gì để tối ưu ngân sách thu thập dữ liệu, hãy liên hệ với AZSOLU. Chúng tôi sẽ “khám” và đưa ra chỉ dẫn giúp tăng hiệu quả cho quá trình SEO trên website của bạn.
BÀI CÙNG CHUYÊN MỤC
Học SEO Từ Nền Tảng IT: Lợi Thế Thật Và Lộ Trình Tự Học
Code sạch, deploy mượt, vậy mà trang vẫn không vào index vì một dòng canonical trỏ sai. Nghe…
Knowledge Panel Là Gì? Cách Google Nhận Diện Thương Hiệu
Mở Google, gõ tên thương hiệu của bạn, rồi nhìn sang cột bên phải. Có một khung thông…
Công Cụ SEO Miễn Phí Bằng Tiếng Việt Cho Người Mới
Năm việc nhỏ là đủ để bạn bắt đầu SEO bằng công cụ, và không việc nào bắt…
Cách Chọn Đơn Vị Làm Backlink: Kiểm Pháp Nhân Trước Khi Trả Tiền
Mở trang giới thiệu của đơn vị bạn định thuê backlink và tìm mã số thuế. Không thấy?…
E-E-A-T Là Gì? Cách Chứng Minh Trải Nghiệm Thật Trên Website
Nhiều người mở Search Console tìm mục “điểm E-E-A-T” để chỉnh, lục cả buổi chiều rồi cay vì…
Cẩm Nang Xây Dựng Quy Trình Triển Khai SEO AI Chuẩn Chuyên Gia Thực Chiến 2026
Quy trình triển khai SEO AI đang định hình lại luật chơi trên bảng xếp hạng tìm kiếm…