
Bạn đã đăng bài, tối ưu SEO đầy đủ nhưng tìm mãi vẫn không thấy trang xuất hiện trên Google? Đây là vấn đề rất phổ biến, đặc biệt với website mới hoặc site chưa tối ưu kỹ thuật. Nguyên nhân cốt lõi thường đến từ việc URL chưa được Google index. Hiểu đúng Google index là bước đầu tiên để SEO hoạt động hiệu quả. Vậy Google index là gì, khác gì với crawl, và cần điều kiện gì để một URL được Google lập chỉ mục? Azsolu sẽ giúp bạn hiểu rõ bản chất ngay trong bài viết dưới đây.
Google Index là gì?
Google Index (lập chỉ mục) là quá trình Google lưu trữ, phân loại và sắp xếp nội dung của các trang web vào hệ thống cơ sở dữ liệu tìm kiếm khổng lồ của mình. Đây là “kho dữ liệu trung tâm” mà Google sử dụng để truy xuất và hiển thị kết quả khi người dùng tìm kiếm. Chỉ những trang đã được Google index mới có khả năng xuất hiện trên trang kết quả tìm kiếm (SERP), được Google đánh giá và xếp hạng theo từ khóa và được tham gia vào các yếu tố SEO như ranking, CTR, traffic
Nói cách khác khi chưa index Google chưa ghi nhận hoặc chưa chấp nhận URL vào hệ thống dữ liệu, trang gần như “vô hình” trên Google. Khi đã index thì URL đủ điều kiện tham gia cạnh tranh thứ hạng, nhưng chưa chắc đã lên top. Hiện nay, Google Index lưu trữ hàng tỷ trang web, được phân loại và đánh giá dựa trên:
- Nội dung và chủ đề
- Ngữ nghĩa (semantic)
- Mức độ hữu ích với người dùng
- Độ tin cậy và uy tín của website
Theo tài liệu chính thức từ Google Search Central, việc một trang được index không đồng nghĩa với việc chắc chắn sẽ được xếp hạng. Google chỉ lưu trữ nội dung vào chỉ mục trước, sau đó mới đánh giá chất lượng và mức độ phù hợp với truy vấn tìm kiếm.
Google Index hoạt động như thế nào?
Quá trình Google đưa một URL vào chỉ mục không diễn ra ngẫu nhiên, mà tuân theo một quy trình kỹ thuật rõ ràng gồm nhiều bước.

-
Googlebot truy cập trang web
Google sử dụng các bot thu thập dữ liệu (chủ yếu là Googlebot) để phát hiện URL mới và truy cập các trang đã tồn tại. Nhờ đó, Googlebot có thể tìm thấy URL thông qua sitemap XML, liên kết nội bộ và backlink từ website khác
-
Thu thập nội dung (Crawl)
Sau khi truy cập URL, Googlebot sẽ đọc mã HTML để thu thập nội dung văn bản, hình ảnh, video sau đó phân tích cấu trúc heading, internal link, schema và cuối cùng là theo dõi các liên kết dẫn sang trang khác
Lưu ý: Crawl chỉ là bước thu thập dữ liệu, không đồng nghĩa với việc URL sẽ được index.
-
Phân tích và đánh giá chất lượng
Đây là giai đoạn Google quyết định URL có đủ giá trị để lưu vào Google Index hay không. Google sẽ đánh giá dựa trên nhiều yếu tố như nội dung có unique không hay trùng lặp với nhiều nội dung khác đã có, trang có đáp ứng đúng search intent người dùng hay chưa, mức độ chuyên sâu và hữu ích có chuẩn không, có tín hiệu của E-E-A-T không và cuối cùng là trải nghiệm người dùng (UX, tốc độ, mobile-friendly) có đáp ứng tốt không.
Những trang có nội dung mỏng, trùng lặp, hoặc không mang lại giá trị thực tế thường bị Google crawl nhưng website không được index.
-
Quyết định đưa URL vào Google Index
Sau khi đã phân tích rõ ràng, Google sẽ index URL nếu đạt tiêu chí chất lượng và kỹ thuật. Ngược lại Google sẽ tạm thời không index hoặc loại bỏ nếu nội dung chưa đạt chuẩn, lỗi kỹ thuật hay do vẫn đang thiếu tín hiệu tin cậy.
Lưu ý: Không phải trang nào được Google crawl cũng sẽ được index. Trên thực tế, rất nhiều website gặp tình trạng bài viết được Googlebot thu thập dữ liệu nhiều lần nhưng vẫn không xuất hiện trên kết quả tìm kiếm. Nguyên nhân phổ biến thường đến từ việc nội dung chưa đủ giá trị, cấu trúc kỹ thuật SEO chưa đạt yêu cầu hoặc website thiếu độ tin cậy tổng thể. Vì vậy, Google Index không chỉ đơn thuần là vấn đề kỹ thuật, mà còn phản ánh trực tiếp chất lượng nội dung và chiến lược SEO tổng thể của website.
Phân biệt Crawl và Index trong SEO
Trong quá trình làm SEO, rất nhiều người vẫn nhầm lẫn giữa crawl và index, trong khi đây là hai giai đoạn hoàn toàn khác nhau trong cách Google xử lý một trang web. Hiểu đúng sự khác biệt này giúp bạn xác định chính xác nguyên nhân vì sao website đã đăng bài nhưng vẫn không hiển thị trên Google.
Google Crawl là gì?
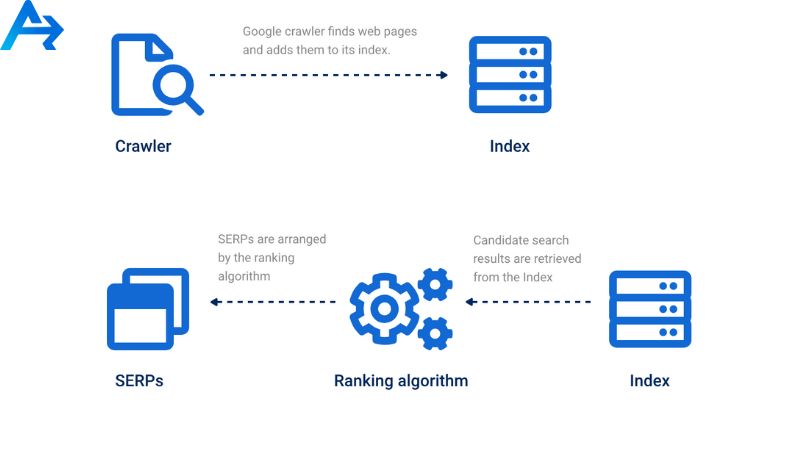
Crawl là quá trình Google sử dụng các bot thu thập dữ liệu (chủ yếu là Googlebot) để truy cập và đọc nội dung của một URL. Mục tiêu của crawl là giúp Google phát hiện và thu thập thông tin từ các trang web trên Internet.
Trong quá trình crawl, Googlebot sẽ:
- Truy cập trực tiếp vào URL
- Đọc mã HTML của trang
- Thu thập nội dung văn bản, hình ảnh, video
- Phân tích cấu trúc heading (H1, H2, H3…)
- Theo dõi các liên kết nội bộ và liên kết ngoài để khám phá các URL khác
Tuy nhiên, cần lưu ý rằng crawl chỉ là bước thu thập dữ liệu, Google chưa đánh giá giá trị nội dung và chưa quyết định việc hiển thị trang trên kết quả tìm kiếm. Một URL có thể được crawl rất nhiều lần nhưng vẫn không xuất hiện trên Google.
Google Index là gì?
Google Index là bước tiếp theo sau crawl, khi Google bắt đầu phân tích, đánh giá và ra quyết định đối với URL đã được thu thập dữ liệu. Ở giai đoạn index, Google sẽ:
- Phân tích nội dung chính của trang
- Đánh giá mức độ unique và trùng lặp
- Xác định search intent mà nội dung đang đáp ứng
- Đánh giá chất lượng tổng thể của trang
- Xem xét các yếu tố kỹ thuật SEO (canonical, noindex, status code…)
- Cân nhắc mức độ tin cậy của website
Chỉ khi Google xác định URL đủ giá trị và phù hợp, trang đó mới được lưu vào Google Index và đủ điều kiện xuất hiện trên kết quả tìm kiếm.
Checklist & quy trình xử lý khi website / bài viết không được Google index
| Bước | Hạng mục kiểm tra | Nội dung cần kiểm tra | Nhận định thực chiến |
|---|---|---|---|
| 1 | Truy cập kỹ thuật | URL không bị chặn bởi robots.txt, không gắn noindex, status code 200, không yêu cầu đăng nhập | Nếu Google không truy cập được trang, mọi tối ưu SEO phía sau đều vô nghĩa |
| 2 | Trạng thái index | Kiểm tra URL trong Google Search Console: Discovered – not indexed / Crawled – not indexed / Indexed | Hai trạng thái chưa index thường không phải lỗi kỹ thuật mà liên quan đến giá trị nội dung |
| 3 | Chất lượng nội dung | Nội dung có unique không, có giải quyết đúng search intent không, có khác biệt so với top hiện tại không | Google không thiếu nội dung, chỉ thiếu lý do để giữ lại nội dung của bạn |
| 4 | Trải nghiệm & insight | Có ví dụ thực tế, tình huống cụ thể, nhận định riêng hay chỉ mô tả lý thuyết | Nội dung “đúng nhưng ai cũng viết được” rất dễ bị crawl nhưng không index |
| 5 | Internal link | URL có được link từ trang pillar, trang có traffic không, có nằm quá sâu trong cấu trúc site không | Google đánh giá giá trị trang thông qua vị trí và ngữ cảnh internal link |
| 6 | Cấu trúc website | Website có tổ chức theo cụm chủ đề (topic cluster) hay các bài viết rời rạc | Site thiếu cấu trúc rõ ràng khiến Google khó xác định trang nào đáng ưu tiên index |
| 7 | Độ tin cậy website | Website có About, Contact rõ ràng, nội dung nhất quán theo chủ đề, có tín hiệu bên ngoài không | Index là quyết định dựa trên niềm tin, không chỉ dựa trên kỹ thuật |
| 8 | Tối ưu lại nội dung | Cập nhật lại bài: mở bài sát pain point, thêm ví dụ, cắt mô tả dư thừa | Trong nhiều case, chỉ cần cải thiện nội dung là Google tự index lại |
| 9 | Gửi URL cho Google | Chỉ submit URL sau khi đã tối ưu nội dung và internal link | Submit khi nội dung chưa đủ tốt thường không mang lại hiệu quả |
| 10 | Theo dõi lại | Theo dõi trạng thái index sau 3–7 ngày, đánh giá lại nếu chưa index | Xử lý index là quá trình, không phải thao tác một lần |
Mối quan hệ giữa Crawl và Index
Trong SEO, việc Google truy cập và đọc trang web (crawl) chỉ là bước đầu, chưa đảm bảo trang đó sẽ xuất hiện trên kết quả tìm kiếm. Để một bài viết có thể hiển thị trên Google, URL bắt buộc phải được lập chỉ mục (index). Điều này có nghĩa là Google đã chấp nhận và lưu trang vào hệ thống dữ liệu của mình. Vì vậy, có nhiều trường hợp Google đã “ghé thăm” trang nhưng vẫn chưa cho hiển thị, dẫn đến các trạng thái như:
- Đã phát hiện nhưng chưa lập chỉ mục (Discovered – currently not indexed)
- Đã thu thập dữ liệu nhưng chưa lập chỉ mục (Crawled – currently not indexed)

Đây là tình trạng khá phổ biến và thường liên quan đến chất lượng nội dung hoặc cấu trúc website.
Google crawl không đồng nghĩa với Google chấp nhận index. Crawl chỉ cho thấy Google đã đọc, còn index mới là việc Google quyết định giữ lại nội dung đó trong hệ thống của mình.
Với các website lớn, việc Google crawl nhưng không index thường liên quan trực tiếp đến Crawl Budget – tức ngân sách thu thập dữ liệu mà Google phân bổ cho mỗi website. Khi ngân sách này bị lãng phí vào các URL không giá trị, các trang quan trọng sẽ bị index chậm hoặc bỏ qua.
Trường hợp 1: Nội dung đúng, nhưng chưa đủ lý do để Google lưu lại
Mình từng audit một blog SEO mới, mỗi bài viết dài khoảng 1.500–2.000 từ, tối ưu đầy đủ heading, internal link, không gặp lỗi kỹ thuật lớn. Trong Google Search Console, các URL đều rơi vào trạng thái:
Crawled – currently not indexed
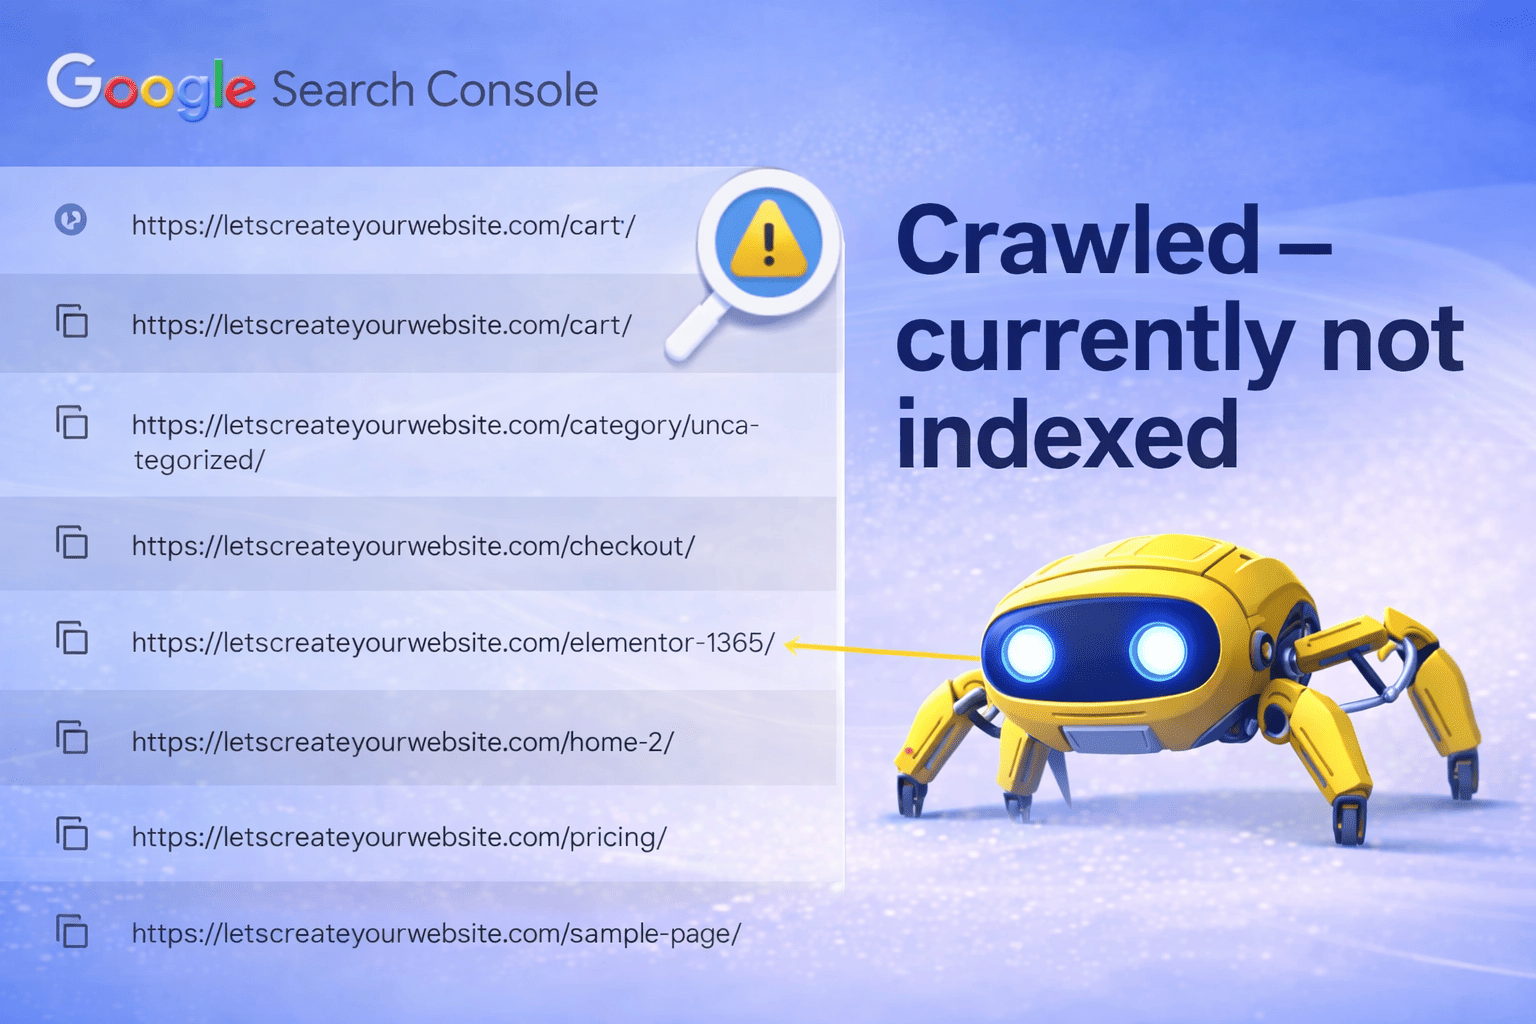
Khi đọc lại nội dung, vấn đề không nằm ở việc viết sai, mà ở chỗ nội dung quá an toàn.
Bài viết đúng kiến thức, giải thích rõ ràng, nhưng cách tiếp cận giống hầu hết những gì đã có trên Google.
Không có:
-
Trải nghiệm thực tế
-
Tình huống cụ thể
-
Nhận định riêng từ người làm SEO
Với Google, những nội dung như vậy không sai, nhưng cũng không đủ khác biệt để phải lưu lại.
Sau khi chỉnh sửa lại bài viết theo hướng:
-
Viết lại mở bài bám sát vấn đề thực tế
-
Bổ sung ví dụ audit và lỗi thường gặp
-
Cắt bớt phần mô tả chung, tăng phần phân tích
URL được Google index sau vài ngày, không cần gửi lại link thủ công.
Trường hợp 2: Website cũ nhưng bài mới vẫn index chậm
Một sai lầm mình thấy khá nhiều là cho rằng website hoạt động lâu năm thì bài mới sẽ tự động được index nhanh. Thực tế không hẳn như vậy.
Có những website đã có tuổi đời vài năm, traffic ổn định, nhưng bài viết mới đăng cả tuần vẫn không xuất hiện trên Google, dù Googlebot vẫn crawl.
Nguyên nhân phổ biến nhất khi audit:
-
Bài mới không được liên kết từ trang mạnh
-
Internal link rời rạc, không theo cụm chủ đề
-
Sitemap có nhưng URL mới nằm quá sâu
Sau khi điều chỉnh lại internal link, dẫn bài mới từ các trang pillar hoặc trang có traffic, thời gian index rút xuống còn 1–2 ngày, thậm chí vài giờ với site có tín hiệu tốt.
Trường hợp 3: Google phát hiện URL nhưng chưa đủ tin tưởng website
Một số website rơi vào trạng thái:
Discovered – currently not indexed
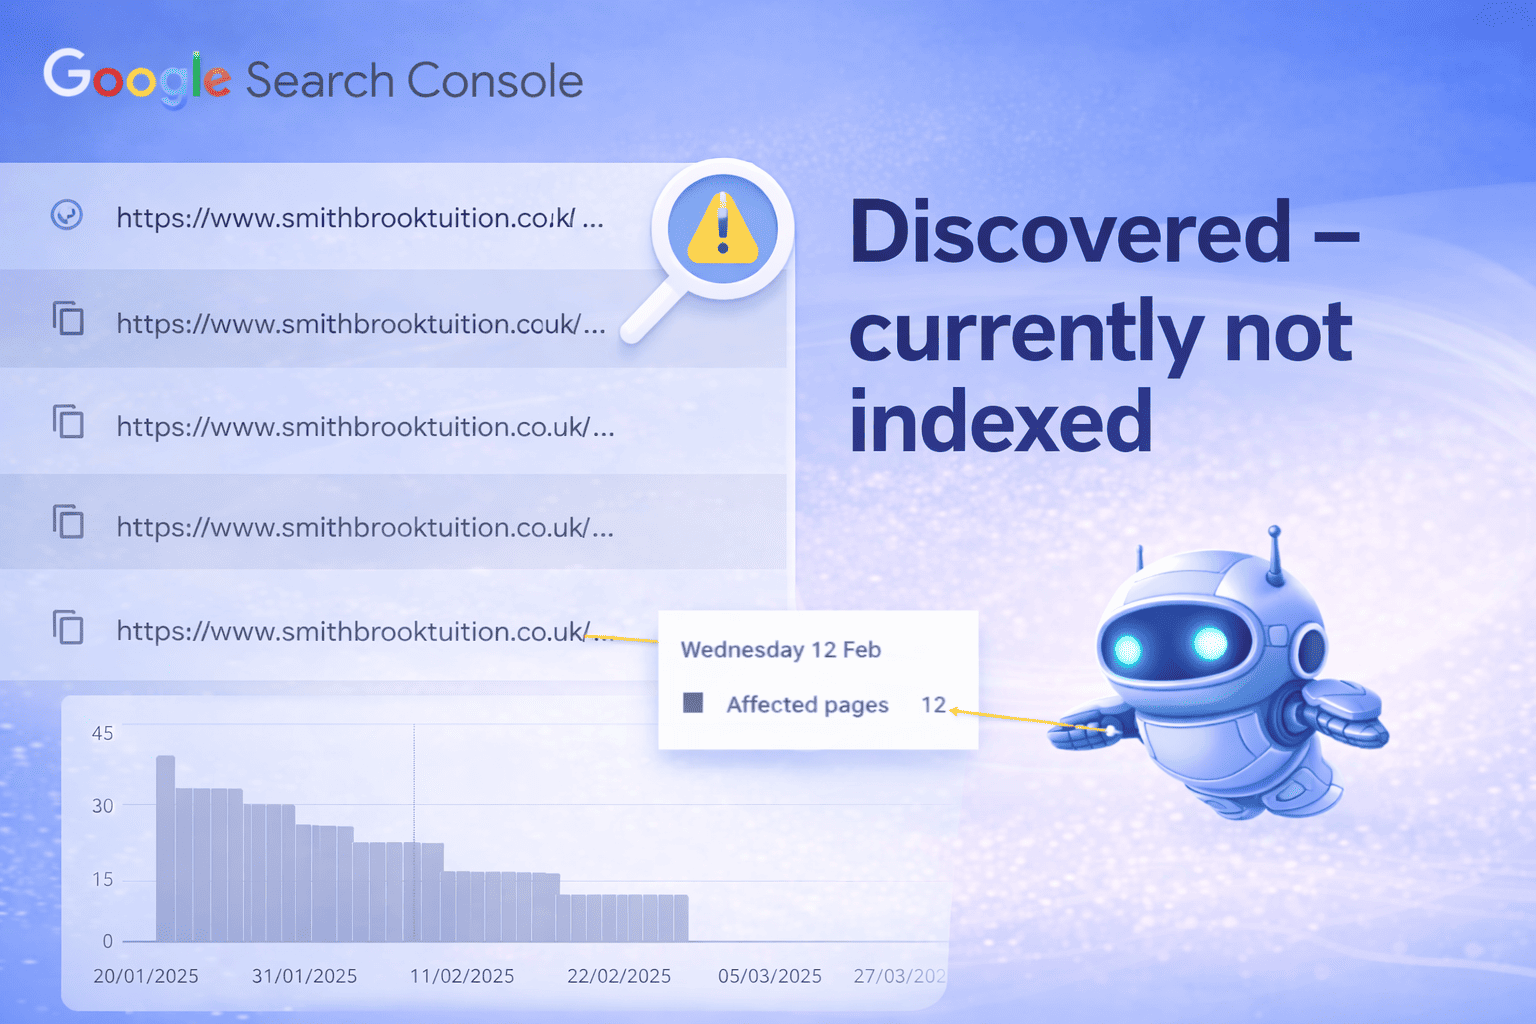
Điều này cho thấy Google biết URL tồn tại, nhưng chưa sẵn sàng crawl sâu và index.
Vấn đề thường không nằm ở từng bài viết, mà ở độ tin cậy tổng thể của website.
Các website này thường có đặc điểm:
-
Nội dung không quá kém
-
Không lỗi kỹ thuật nghiêm trọng
-
Nhưng thiếu tín hiệu tin cậy: brand, liên kết, lịch sử hoạt động
Khi bổ sung lại các yếu tố nền tảng như:
-
Liên kết nội bộ chặt chẽ hơn
-
Một số backlink chất lượng vừa đủ
-
Chuẩn hóa thông tin website (About, Contact, schema cơ bản)
Google bắt đầu crawl sâu hơn và index ổn định các URL mới.
Bảng so sánh Crawl và Index

| Tiêu chí | Crawl | Index |
| Bản chất | Thu thập dữ liệu | Lưu trữ và phân loại dữ liệu |
| Mục đích | giúp Google đọc nội dung trang | Quyết định có hiển thị trên Google hay không |
| Thời điểm | Giai đoạn đầu | Giai đoạn sau crawl |
| Đánh giá chất lượng | Không | Có |
| Kiểm tra search intent | Không | Có |
| Ảnh hưởng đến SEO | Chưa tạo giá trị SEO | Điều kiện bắt buộc để bắt đầu SEO |
| Có thể hiển thị trên Google | Không | Có khả năng |
Bảng so sánh Crawl và Index
Tóm lại:
- Crawl là điều kiện cần, giúp Google thu thập dữ liệu
- Index là điều kiện bắt buộc, quyết định URL có được hiển thị hay không
- Một URL có thể được crawl nhiều lần nhưng vẫn không được index nếu không đạt yêu cầu
Chính vì vậy, Google Index không chỉ là vấn đề kỹ thuật, mà còn phản ánh chất lượng content và chiến lược SEO tổng thể của website.
Điều kiện để một URL được Google Index
Để một URL được Google index, cần đảm bảo các điều kiện sau:
Trang không bị Google chặn
Trước hết, Google phải truy cập được trang web. Điều này có nghĩa là:
- Trang không bị chặn kỹ thuật
- Không yêu cầu đăng nhập hay mật khẩu
- Không bị hệ thống bảo mật ngăn Google truy cập
Nếu Google không “vào được” trang, dù nội dung có tốt đến đâu cũng sẽ không được hiển thị.
Nội dung đủ giá trị để Google lưu lại
Google chỉ muốn hiển thị những trang thực sự hữu ích cho người tìm kiếm. Vì vậy nội dung cần rõ ràng, dễ hiểu, giải quyết đúng vấn đề người dùng quan tâm nên tránh các bài viết quá ngắn, sơ sài hoặc sao chép và bài viết nên được trình bày gọn gàng, có tiêu đề và bố cục rõ ràng
Nội dung càng chất lượng, khả năng được Google index và hiển thị càng cao.
Website hoạt động ổn định, không lỗi kỹ thuật. Google luôn ưu tiên những trang web có hoạt động bình thường, không bị lỗi, tải nhanh, dễ xem trên điện thoại và không bị chuyển hướng sai hoặc lỗi hiển thị. Nếu website thường xuyên lỗi hoặc tải chậm, Google có thể chưa vội hiển thị trang đó.
Trang có sự liên kết và độ tin cậy
Google đánh giá cao những website có nhiều trang liên kết với nhau cùng với lịch sử hoạt động ổn định và được các website khác giới thiệu hoặc nhắc đến. Những yếu tố này giúp Google tin tưởng hơn và index trang nhanh hơn.
Câu hỏi thường gặp (FAQ)
Bao lâu thì một bài viết mới có thể xuất hiện trên Google?
Thời gian hiển thị không cố định. Có bài chỉ vài giờ, nhưng cũng có bài mất vài ngày hoặc vài tuần, tùy vào chất lượng nội dung, cấu trúc website và độ tin cậy tổng thể của trang web.
Vì sao website cũ nhưng bài viết mới vẫn lên Google rất chậm?
Dù website đã hoạt động lâu năm, nếu bài viết mới không được liên kết nội bộ tốt, nội dung chưa nổi bật hoặc website gặp lỗi kỹ thuật, Google vẫn có thể ưu tiên hiển thị các trang khác trước.
Gửi link bài viết cho Google có đảm bảo chắc chắn sẽ được hiển thị không?
Việc gửi link chỉ giúp Google biết rằng trang đó tồn tại, không đảm bảo 100% sẽ được hiển thị. Google vẫn cần đánh giá chất lượng nội dung và độ phù hợp trước khi quyết định lập chỉ mục.
Một trang không được hiển thị có ảnh hưởng đến toàn bộ website không?
Nếu chỉ một vài trang không được hiển thị thì ảnh hưởng không lớn. Tuy nhiên, nếu nhiều trang gặp tình trạng này, Google có thể đánh giá website chưa đủ chất lượng, từ đó ảnh hưởng đến hiệu quả SEO chung.
Có nên xóa các bài viết không được Google hiển thị?
Không nên xóa ngay. Trước tiên cần kiểm tra lý do, tối ưu lại nội dung, cấu trúc và liên kết. Chỉ nên xóa khi bài viết không còn giá trị hoặc trùng lặp nghiêm trọng.
Kết luận
Trong thực tế, không phải website nào index chậm cũng cần xử lý kỹ thuật phức tạp. Phần lớn các trường hợp đến từ việc nội dung chưa tạo được khác biệt hoặc website chưa đủ tín hiệu tin cậy trong mắt Google. Việc hiểu đúng bản chất của Google Index giúp SEOer tránh lãng phí thời gian vào những thao tác không cần thiết.
Azsolu cung cấp dịch vụ audit index, technical SEO và content SEO, giúp website được Google index đúng – nhanh – ổn định. Từ đó nâng cao khả năng lên top và tăng trưởng traffic bền vững trong dài hạn.
BÀI CÙNG CHUYÊN MỤC
Học SEO Từ Nền Tảng IT: Lợi Thế Thật Và Lộ Trình Tự Học
Code sạch, deploy mượt, vậy mà trang vẫn không vào index vì một dòng canonical trỏ sai. Nghe…
Knowledge Panel Là Gì? Cách Google Nhận Diện Thương Hiệu
Mở Google, gõ tên thương hiệu của bạn, rồi nhìn sang cột bên phải. Có một khung thông…
Công Cụ SEO Miễn Phí Bằng Tiếng Việt Cho Người Mới
Năm việc nhỏ là đủ để bạn bắt đầu SEO bằng công cụ, và không việc nào bắt…
Cách Chọn Đơn Vị Làm Backlink: Kiểm Pháp Nhân Trước Khi Trả Tiền
Mở trang giới thiệu của đơn vị bạn định thuê backlink và tìm mã số thuế. Không thấy?…
E-E-A-T Là Gì? Cách Chứng Minh Trải Nghiệm Thật Trên Website
Nhiều người mở Search Console tìm mục “điểm E-E-A-T” để chỉnh, lục cả buổi chiều rồi cay vì…
Cẩm Nang Xây Dựng Quy Trình Triển Khai SEO AI Chuẩn Chuyên Gia Thực Chiến 2026
Quy trình triển khai SEO AI đang định hình lại luật chơi trên bảng xếp hạng tìm kiếm…